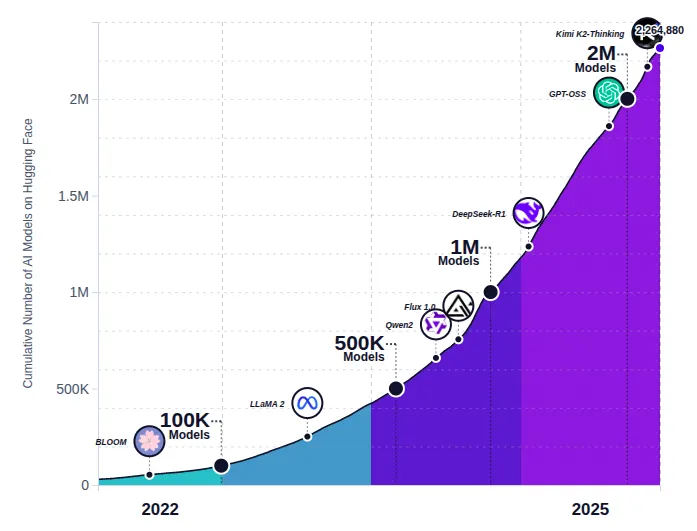
Desde que a primeira versão do ChatGPT foi anunciada em 2022, é fato que a quantidade de modelos, tanto proprietários quanto open source aumentaram exponencialmente.
O gráfico abaixo ilustra isso: A quantidade de modelos open source na plataforma Hugging Face (obs: o gráfico não inclui o ano de 2026 que teve lançamentos importantes, como o KIMI K3).
 Fonte: https://aiworld.eu/story/hugging-faces-two-million-models-and-counting.
Entre 2022 e 2025, o número de modelos no repositório da Hugging Face seguiu uma trajetória praticamente exponencial. Hoje o repositório conta com mais de 2 milhões de modelos abertos.
É interessante notar que a plataforma abraça tanto modelos de pequeno porte , os chamados Small LLMs, quanto modelos grandes, como gpt-oss.
Além dos números mostrarem a força que a comunidade open source possui, fica claro que LLMs se tornaram mais acessíveis.
É fato que treinar grandes modelos, como os provenientes de empresas como Antropic, OpenAI e Google ainda custam algumas centenas de milhões de dólares, mas para startups e um público geral o treinamento deixou de ser um gargalo, dado a abundância de modelos pré-treinados disponíveis, o custo para se incorporar ia a um produto caiu drasticamente, o diferencial deixa de estar apenas na criação do modelo, agora, o verdadeiro desafio está em servir essees modelos de forma eficiente.
Um modelo que leva dezenas de segundos para responder, consome recursos excessivos ou custa mais do que o valor gerado para o negócio simplesmente não é viável em produção. Cada novo usuário implica mais requisições concorrentes, mais memória consumida, maior demanda computacional e uma conta de infraestrutura cada vez mais elevada. É nesse contexto que surge a Engenharia de Inferência.
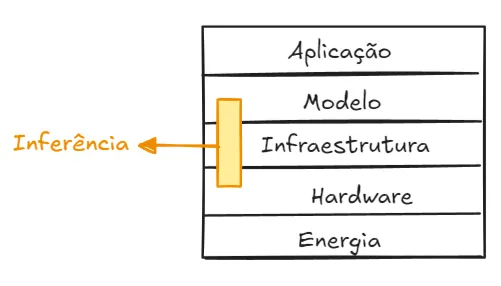
Ela atravessa 3 camadas da “pilha de ia”:
Para entendermos inferência precisamos entender onde ela se encaixa no pipeline de treinamento de um LLM:
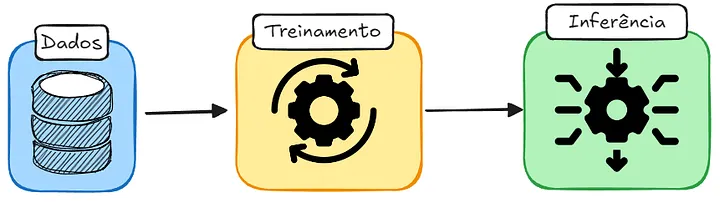
Inferência no contexto de machine learning puro significa utilizar o modelo treinado para gerar previsões ou saídas a partir de novas entradas.
Dentro do contexto de Engenharia de Inferência, quando empresas falam sobre inferência, elas estão frequentemente se referindo ao problema de executar e servir modelos em produção.
Portanto, podemos definir a Engenharia de Inferência como a prática de tornar modelos de ia generativa mais rápidos, mais baratos e mais confiáveis, sem sacrificar a qualidade.
A Engenharia de Inferência atravessa diferentes camadas da pilha de IA: aplicação, modelo, infraestrutura, hardware e energia. A aplicação define requisitos como latência e qualidade; o modelo determina as necessidades computacionais; a infraestrutura fornece os recursos para executá-lo em escala; o hardware define os limites de computação e memória; e a energia representa o custo físico de manter toda essa operação funcionando.
Inferência para modelos de machine learning clássicos era um processo relativamente simples, exigindo CPUs leves e podia ser resolvida com uma simples stack de software.
Quando pensamos em LLMs, especialmente os de larga escala, esse processo se torna mais complexo, é por isso importante entendermos as 3 camadas da inferência:
Runtime: Otimização de performance de um modelo executado em uma única GPU.
Infraestrutura: Escalar por meio de clusters, regiões e diferentes provedores de cloud, com excelente uptime.
Tools (Ferramentas): Mesmo com runtimes eficientes e infraestruturas ótimas, engenheiros ainda precisam de ferramentas que tornem o trabalho viável; aqui estamos falando de SDKs, APIs, profilers e ferramentas de deploy.
Mensurando latência e throughput
Quando discutimos LLMs em produção, duas métricas se destacam: TTFT e TPS. TTFT, que significa Time to first token, refere-se ao tempo que corre entre o envio da requisição e a geração do primeiro token.
É fundamental entender que o TTFT é fortemente influenciado pela fase de prefill. Nessa etapa, o modelo precisa processar todo o prompt antes de começar a gerar a resposta. Durante o prefill, o modelo recebe todos os tokens do prompt de uma só vez. Isso significa que ele precisa executar todas as operações necessárias para processar essa sequência e construir o estado necessário para começar a geração dos tokens. O prefill é uma fase predominantemente compute-bound, ou seja, o gargalo tende a ser a capacidade computacional da GPU.
A próxima métrica TPS se relaciona diretamente com o decode. Após a produção do primeiro token, o modelo precisa gerar o segundo. O TPS, ou Tokens per second, referese-à velocidade com que os tokens são gerados; é uma operação que requer grande quantidade de banda de memória, isto é, a velocidade com que os pesos e outros dados do modelo podem ser movimentados entre a memória e a GPU.
Portanto, podemos concluir que as métricas são importantes, porém se aplicam a fases distintas, diferentes gargalos e necessitam de otimizações específicas.
Ententendo os gargalos na inferência
A GPU oferece dois tipos de recursos: recurso de computação medido em ops, operations per second, e banda de memória, mensurada em bytes por segundo. Em um cenário ideal, nenhum dos dois espera pelo outro; na realidade, um está com processamento saturado enquanto o outro está esperando.
Isso é de extrema importância para o diagnóstico de problemas com inferência; se uma operação requer essencialmente memória, otimizar poder de GPU não vai torná-la mais rápida.
Podemos então separar as fases:
- Prefill é limitado pelo poder computacional da GPU
- Decode é limitado pela velocidade de movimentação de dados entre a memória e a GPU.
Ops/bytes
Ops/bytes se refere a quantidade de operações por byte de memória que a GPU deve performar para manter todos os seus recursos trabalhando de forma eficiênte. Nós definimos AI ( Arithmetic Intensity ) como sendo a razão essa razão da quantidade de operações pelos bytes movimentados.
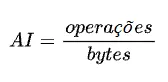
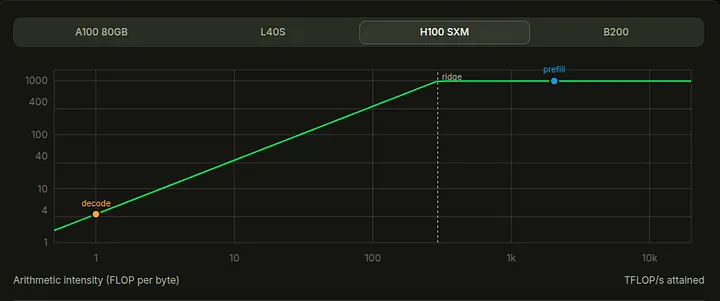
O gráfico mostra a relação entre a quantidade de operações que a GPU precisa executar e a quantidade de dados que precisa movimentar na memória, chamada de Arithmetic Intensity, medida em FLOP/byte. Quanto menor essa relação, mais a operação depende da velocidade da memória, pois a GPU precisa movimentar muitos dados para realizar poucas operações; por isso, ela é considerada memory-bound. Conforme a quantidade de operações por byte aumenta, a capacidade computacional da GPU passa a ser o principal limite, caracterizando uma operação compute-bound. O ponto chamado ridge point representa a transição entre esses dois cenários. No contexto de LLMs, o decode tem baixa intensidade aritmética e tende a ficar na região memory-bound, então seu desempenho depende principalmente da largura de banda da memória. Já o prefill tem uma intensidade aritmética muito maior e tende a ficar na região compute-bound, fazendo com que a capacidade de processamento da GPU seja mais importante. Por isso, o gráfico explica por que usar apenas uma GPU com mais FLOPs nem sempre acelera a inferência: se o gargalo for a memória, é preciso reduzir a quantidade de dados movimetnados ou aumentar a largura de banda; se a operação for limitada pela computação, então mais FLOPs ajudam a melhorar o desempenho.
Técnicas de Otimização
Existem diversas formas de otimização; no entanto, neste artigo vou focar em duas: Quantização (Quantization), Model Parallelism. Cada uma atua sobre diferentes aspectos do processo de inferência, visando reduzir o consumo de memória, ganhar desempenho e permitir que modelos maiores sejam executados com maior eficiência.
Quantização (Quantization)
Quantization é a técnica que reduz os custos computacionais e de memória necessários na inferência, representando os pesos (weights) e as funções de ativação de um modelo com tipos de dados de baixa precisão, como, por exemplo, um inteiro de 8 bits , (int8) em vez do usual float32 (32-bit floating point).
Reduzir o número de bits significa que o modelo vai precisar de menos memória e consumir menos energia (em teoria). Operações como a multiplicação de matrizes podem ser realizadas muito mais rapidamente com aritmética de inteiros. Esse tipo de otimização também permite que alguns modelos sejam executados em dispositivos embarcados, que muitas vezes suportam apenas tipos de dados inteiros.
Os casos mais comuns de quantização são: float32 -> float16, float32 -> int8.
Para entendermos o impacto da quantização, vou voltar ao tópico do roofline. Se tivermos um modelo no qual seus pesos ocupam, por exemplo, 10 GB, se estivermos utilizando 16 bits por parâmetro e reduzirmos para 8 bits, teremos esse valor pela metade, ou seja, 5 GB. Isso significa que, durante a fase de decode, menos dados vão precisar ser movimentados; essa redução pode ser bastante efetiva caso o problema seja a banda de memória.
O impacto na qualidade
A quantização é uma das técnicas apresentadas que podem silenciosamente tornar o llm pior. Ela não produz nenhum tipo de erro e entrega o throughput desejado, mas pode degradar a qualidade do output. O mais importante é comparar diferentes níveis de quantização e ir observando o ganho de desempenho e a possível perda de qualidade.
Model Parallelism
À medida que o tamanho e a complexidade do modelo aumentam, uma única GPU não é suficiente: ou ela não comporta mais o modelo ou ele começa a ficar extremamente lento. Quando os modelos excedem a capacidade de memória de uma única GPU, as técnicas de paralelização são empregadas para dividir a carga de trabalho e otimizar a inferência.
Paralelismo de dados (DP)
O paralelismo de dados envolve duplicar o modelo em várias GPUs ou clusters de GPU. Cada GPU processa de forma independente grupos de requests de usuários. Esse método escala linearmente com o número de GPUs usadas, o que significa que o número de solicitações atendidas aumenta diretamente com os recursos de GPU alocados. No entanto, é importante observar que o DP sozinho geralmente não é suficiente para os LLMs em larga escala, pois os pesos do modelo geralmente não cabem em uma única GPU. Consequentemente, o DP é comumente usado juntamente com as outras técnicas de paralelismo.
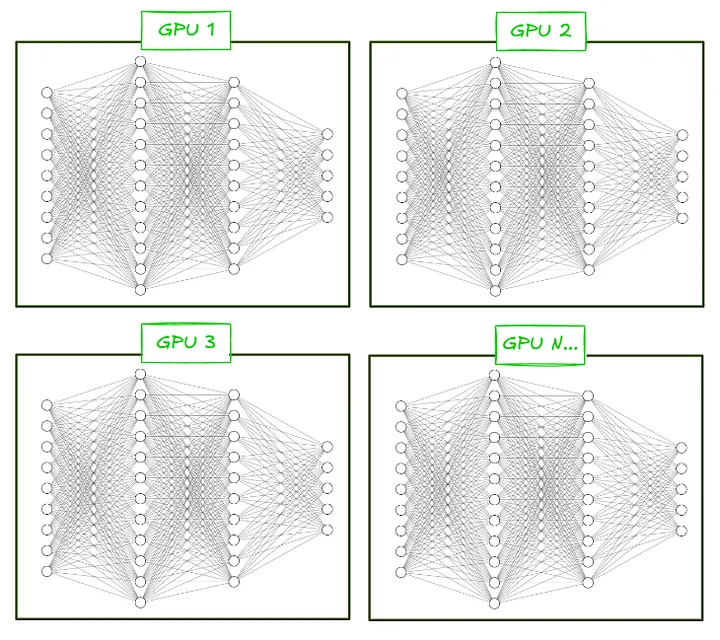
Em termos de desempenho a taxa de transferência da GPU não é afetada pelo DP à medida que o modelo é duplicado, também não possui impacto significativo na interatividade do usuário, pois as requisições são processadas de forma independente.
Paralelismo de Tensores
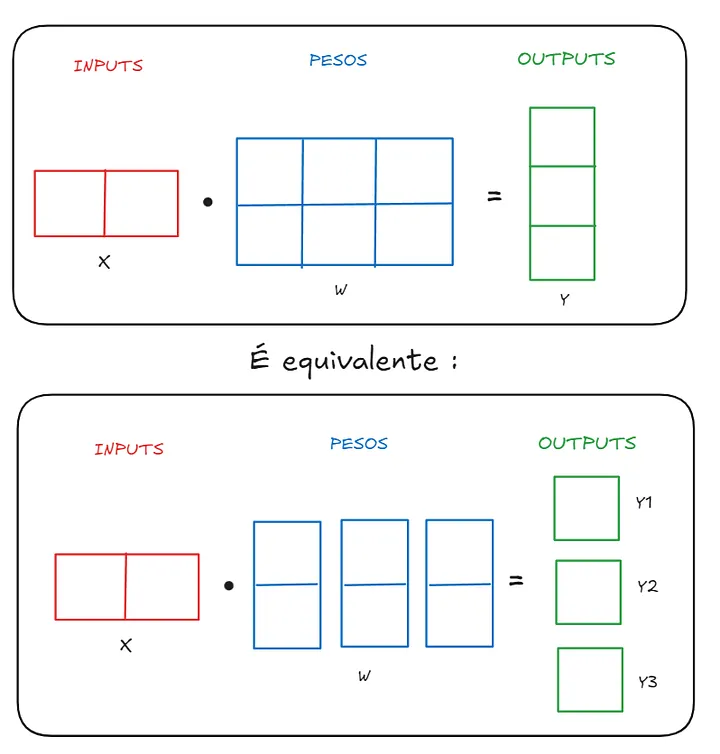
No paralelismo de tensores, os parâmetros são divididos em várias GPUs, com requisições de usuários compartilhadas entre GPUs ou clusters de GPUs. Os resultados dos cálculos realizados em diferentes GPUs são combinados na rede de GPU a GPU. Esse método pode melhorar a interatividade do usuário, especialmente para modelos baseados na arquitetura Transformer, como o Llama e o GPT, garantindo que cada solicitação seja processada com mais recursos de GPU, acelerando o tempo de processamento.
Por exemplo, quando vamos multiplicar um tensor de input com o tensor de pesos, a multiplicação matricial entre eles é equivalente a separar os pesos em vetores coluna, multiplicando cada coluna com o input de modo separado, e depois concatenamos os outputs.
Paralelismo de Pipeline
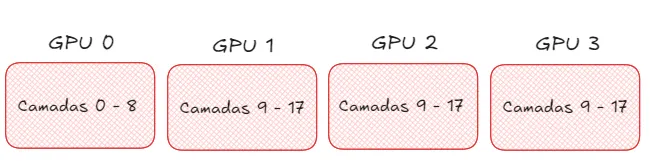
O paralelismo de pipeline divide as camadas do modelo, com cada grupo de camadas atribuído a diferentes GPUs. O modelo processa solitações sequencialmente em GPUs, com cada GPU realizando computações em sua parte atribuída do modelo, esse método é muito eficaz e benéfico para distribuir pesos de modelos grandes, aqueles que não cabem em uma única GPU.
Conclusão A Engenharia de Inferência se tornou um dos pilares mais importantes da IA generativa em produção. Hoje existem muitos modelos pré-treinados, abertos ou proprietários. O que faz diferença agora não é só ter um modelo, mas conseguir usá-lo de forma rápida, barata e confiável. Otimizar inferência é um exercício de equilíbrio entre latência, throughput, custo e qualidade. O ponto ideal depende do caso de uso, do perfil de tráfego e dos recursos disponíveis. Quantização e paralelismo de modelos atuam sobre aspectos diferentes do problema. Na prática, costumam ser combinados. Por isso, o caminho mais seguro é medir, identificar o gargalo e só então aplicar a técnica adequada. À medida que os modelos crescem e a demanda por IA em produção aumenta, dominar a Engenharia de Inferência será cada vez mais um diferencial para quem constrói produtos com LLMs.
Referências
https://huggingface.co/docs/text-generation-inference/conceptual/tensor_parallelism
https://huggingface.co/docs/optimum/en/concept_guides/quantization
https://huggingface.co/docs/transformers/perf_train_gpu_many